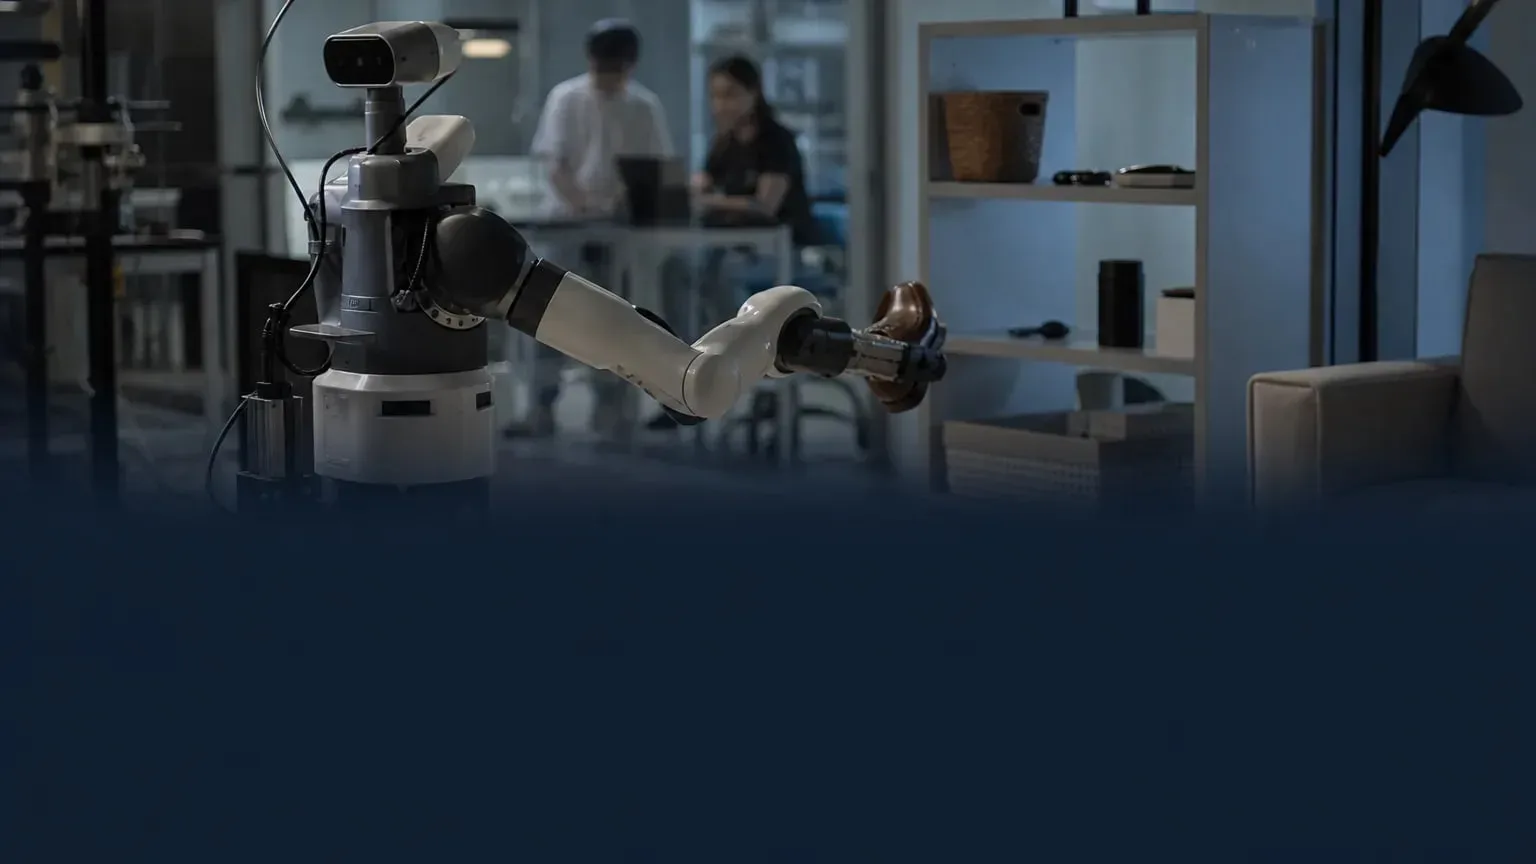
طوّر باحثون في معهد ماساتشوستس للتكنولوجيا نظام ذاكرة جديدًا للروبوتات صُمّم لالتقاط الأوصاف الخاطئة قبل أن تنتشر داخل خريطة الروبوت للعالم. ويُسمّى النظام UQ-DAAAM، وهو يساعد الروبوت على تحديد الأوصاف غير المؤكدة، وجمع زوايا أفضل لنفس الجسم، واستبدال العناوين غير الموثوقة بعناوين أدق.
حقائق أساسية
- UQ-DAAAM اختصار لعبارة «تقدير عدم اليقين لوصف أي شيء، في أي مكان، وفي أي لحظة».
- يقارن النظام بين أوصاف متعددة للجسم نفسه من زوايا مختلفة لقياس درجة عدم اليقين.
- عندما يكون عدم اليقين مرتفعًا، يختار الروبوت زوايا إضافية لتحسين الوصف ويخزن الصياغة المنقحة في الذاكرة.
- في الاختبارات، حسمت الطريقة الغموض لدى نحو 92 بالمئة من الأجسام باستخدام وصفين إضافيين فقط لكل جسم.
- قال الباحثون إن النظام حسّن دقة أوصاف الأجسام بنسبة 5 بالمئة مقارنة بأحدث ما توصلت إليه التقنيات المشابهة.
ماذا يعني ذلك للروبوتات في المنازل وأماكن العمل؟
الأثر العملي هو أن الروبوت يصبح أقل عرضة للاحتفاظ بملصق خاطئ لشيء مهم، مثل الخلط بين جهاز إزالة الرجفان ومطفأة الحريق. وهذا مهم عندما يُتوقع من الآلة أن تساعد في بيئات حساسة زمنيًا أو تنجز مهام متعددة الخطوات تعتمد على معرفة الشيء ومكان رؤيته آخر مرة.
النظام موجّه للروبوتات التي تتحرك داخل البيئة، وتجمع الصور عبر الوقت، وتخزن هذه الصور على هيئة عناوين في ذاكرة مبنية على خريطة ثلاثية الأبعاد. ومن خلال استخدام زوايا إضافية فقط عندما يكون عدم اليقين مرتفعًا، صُممت الطريقة لتحديث الذاكرة في الزمن الحقيقي من دون إعادة تشغيل نموذج الرؤية واللغة لكل إطار.
ويرى الباحثون أن هذا الأسلوب قد يفيد الروبوتات المنزلية أو الصناعية، بما في ذلك الآلات التي تنقل الأطباق من الطاولة أو تعمل مع البشر لتجميع المعدات. كما يقولون إن إطار تقدير عدم اليقين نفسه قد يمتد لاحقًا إلى الأذرع الروبوتية المتنقلة وإلى مهام تنبؤية أخرى.
كيف يعمل UQ-DAAAM؟
يبني النظام على إطار الذاكرة السابق للفريق، DAAAM، الذي يستخدم نموذج رؤية ولغة لإنشاء أوصاف تفصيلية للأجسام التي تلتقطها كاميرات الروبوت المثبتة عليه. ويضيف UQ-DAAAM طبقة تتحقق من مدى الثقة في كل وصف قبل حفظه ضمن الذاكرة.
ويفعل ذلك عبر خطوتين. أولًا، يقيم درجة ثقة نموذج اللغة في الكلمات التي ولّدها. ثم يقارن الأوصاف الخاصة بالجسم نفسه من زوايا مختلفة ليرى ما إذا كانت متسقة. وتُدمج هذه الإشارات في درجة واحدة لعدم اليقين. وإذا كانت الدرجة مرتفعة جدًا، يبحث الروبوت عن صور إضافية أكثر فائدة لنفس الجسم ويستخدمها لتنقيح الوصف.
ويقول الباحثون إن طريقة الاختيار التي طوروها تستطيع تحديد أفضل الإطارات الإضافية من دون إعادة تشغيل نموذج الرؤية واللغة، ما يقلل الحوسبة بما يكفي لتمكين روبوت متحرك من مواصلة تحديث الذاكرة أثناء الحركة.
لماذا تهم ذاكرة الروبوت الأفضل؟
الروبوتات العاملة في البيئات الواقعية لا ترى الأجسام بوضوح دائمًا. فقد تواجه لقطات جزئية أو أجسامًا بعيدة أو صورًا ضبابية أو إضاءة ضعيفة. وفي مثل هذه الحالات، قد يبقى الوصف الخاطئ في الذاكرة ويؤثر في الأفعال والإجابات اللاحقة.
مع UQ-DAAAM، يمكن للروبوت مراجعة الوصف عندما تشير الأدلة عبر الزوايا المختلفة إلى أن الملصق الأصلي قد يكون غير صحيح. ويقول الباحثون إن ذلك يحسن ليس فقط أوصاف الأجسام، بل أيضًا الإجابات عن أسئلة تتعلق بالمكان الذي شاهد فيه الروبوت شيئًا ما، ومتى رآه آخر مرة.
ماذا أفاد الباحثون؟
قال الفريق إن خطوة التنقيح تمكنت من حل الالتباس لدى نحو 92 بالمئة من الأجسام في بيئة الروبوت، مع الحاجة إلى وصفيْن إضافييْن فقط لكل جسم. وبالمقارنة مع الطرق المرجعية، حسّن النظام دقة أوصاف الأجسام بنسبة 5 بالمئة.
عمل المؤلفان الرئيسيان المشاركان هاري جانغ ونيكولا غورلو مع المؤلف الكبير لوكا كارلوني، الأستاذ المشارك في قسم الملاحة الجوية والفضاء في معهد ماساتشوستس للتكنولوجيا والباحث الرئيسي في مختبر أنظمة المعلومات واتخاذ القرار. ومن المقرر عرض البحث في مؤتمر أنظمة معالجة المعلومات العصبية.
وحظي العمل بدعم جزئي من مختبر أبحاث الجيش الأمريكي ومكتب الأبحاث البحرية الأمريكي.
ما الخطوة التالية؟
يقول الباحثون إنهم يريدون استخدام UQ-DAAAM مع أنواع أخرى من الروبوتات، بما في ذلك الأذرع الروبوتية المتنقلة. كما يدرسون ما إذا كان النظام يمكنه إرشاد الروبوتات إلى مناطق ذات عدم يقين مرتفع حتى تعود إليها وتحسن فهمها للبيئة.
وهدف آخر هو تطبيق أساليب مماثلة لتقدير عدم اليقين على أنظمة تتنبأ بكيفية تغير بيئة الروبوت في المستقبل.